12.4 - Indexing
Tóm tắt: Index là đòn bẩy hiệu năng lớn nhất trong database — và cũng là nơi dễ làm sai nhất. Ba điều quyết định. Thứ tự cột trong composite index không thể hoán đổi: index
(Status, CreatedAt)phục vụWHERE Status = 'New'nhưng vô dụng choWHERE CreatedAt > ...đơn thuần.SARGable: bọc cột trong hàm —WHERE YEAR(CreatedAt) = 2026— làm index hoàn toàn không dùng được, dù index đó tồn tại. Và index không miễn phí: mỗi index làm chậm mọiINSERT,UPDATE,DELETE, chiếm dung lượng, và kéo dài thời gian sao lưu. Nhiều hệ thống chậm vì thừa index chứ không phải thiếu.
Mục tiêu bài học
Sau bài này bạn có thể:
- Giải thích B-tree và vì sao index tăng tốc tìm kiếm.
- Chọn đúng thứ tự cột trong composite index.
- Nhận ra truy vấn không SARGable và sửa nó.
- Dùng covering index để loại bỏ key lookup.
- Tìm và xoá index thừa.
Nội dung bài học
12.4.1 — B-tree và index gom cụm
Index là một B-tree: cây cân bằng mà mỗi nút chứa nhiều khoá đã sắp xếp. Tìm một giá trị trong 10 triệu dòng chỉ mất 3–4 lần đọc trang thay vì quét toàn bộ.
                [1000 | 5000]
               /      |      \
       [200|500]  [2000|3000]  [7000|9000]
Index gom cụm (clustered) là chính dữ liệu, được sắp xếp theo khoá. Mỗi bảng chỉ có một, vì dữ liệu chỉ sắp xếp được theo một thứ tự.
Index không gom cụm là cấu trúc riêng chứa khoá index cộng một con trỏ về dòng thật. Trong SQL Server, con trỏ đó là khoá gom cụm — lý do khoá gom cụm nhỏ lại quan trọng (bài 12.1).
Bảng không có index gom cụm gọi là heap: dữ liệu nằm lộn xộn, và mọi tra cứu phải qua RID. Gần như luôn nên có index gom cụm.
12.4.2 — Thứ tự cột là tất cả
CREATE INDEX IX_Leads_Status_CreatedAt ON Leads (Status, CreatedAt DESC);Hình dung nó như danh bạ sắp theo (Họ, Tên):
| Truy vấn | Dùng được index? |
|---|---|
WHERE Status = 'New' | Có — seek |
WHERE Status = 'New' AND CreatedAt > '2026-01-01' | Có — seek tốt nhất |
WHERE CreatedAt > '2026-01-01' | Không — như tìm mọi người tên "An" trong danh bạ theo họ |
WHERE Status IN ('New','Contacted') ORDER BY CreatedAt DESC | Một phần |
Nguyên tắc leftmost prefix: index dùng được cho các tiền tố trái liên tục của danh sách cột.
Đặt cột nào trước?
- Cột dùng với so sánh bằng (
=) trước cột dùng với khoảng (>,<,BETWEEN). - Trong các cột bằng, đặt cột lọc mạnh hơn trước.
-- Query: WHERE TenantId = @t AND Status = 'New' AND CreatedAt > @d
CREATE INDEX IX_Leads_Tenant_Status_Created
    ON Leads (TenantId, Status, CreatedAt DESC);
Sau một cột dùng khoảng, mọi cột tiếp theo không còn dùng để seek — chỉ để lọc trong tập đã tìm được. Đó là lý do cột khoảng phải đứng cuối.
DESC trong định nghĩa index quan trọng khi bạn luôn ORDER BY CreatedAt DESC: nó cho phép đọc index theo đúng chiều, không cần bước sắp xếp.
12.4.3 — SARGable
SARGable = Search ARGument able — điều kiện mà database dùng được index để seek.
-- KHÔNG SARGable — hàm bọc quanh CỘT
WHERE YEAR(CreatedAt) = 2026
WHERE UPPER(Email) = '[email protected]'
WHERE CONVERT(DATE, CreatedAt) = '2026-03-15'
WHERE CompanyName LIKE '%tech%'          -- wildcard o DAU
WHERE EstimatedValue + Discount > 1000
WHERE ISNULL(Status, 'New') = 'New'

-- SARGable — cột đứng một mình
WHERE CreatedAt >= '2026-01-01' AND CreatedAt < '2027-01-01'
WHERE Email = '[email protected]'                  -- chuan hoa chu thuong khi ghi
WHERE CreatedAt >= '2026-03-15' AND CreatedAt < '2026-03-16'
WHERE CompanyName LIKE 'tech%'           -- wildcard o CUOI
WHERE EstimatedValue > 1000 - Discount
WHERE Status = 'New' OR Status IS NULL
Quy tắc duy nhất cần nhớ: cột phải đứng một mình ở một vế. Bọc nó trong hàm là database phải tính hàm đó cho mọi dòng trước khi so sánh — tức quét toàn bảng, dù index tồn tại.
Đây là nguyên nhân phổ biến nhất của "tôi đã tạo index rồi mà vẫn chậm".
Cần lọc theo biểu thức thật thì tạo index trên biểu thức:
-- SQL Server: cột tính toán
ALTER TABLE Leads ADD CreatedYear AS YEAR(CreatedAt) PERSISTED;
CREATE INDEX IX_Leads_CreatedYear ON Leads(CreatedYear);

-- PostgreSQL: index trên biểu thức, không cần thêm cột
CREATE INDEX idx_leads_created_year ON leads (EXTRACT(YEAR FROM created_at));
12.4.4 — Key lookup và covering index
CREATE INDEX IX_Leads_Status ON Leads (Status);

SELECT LeadId, CompanyName, Status, EstimatedValue
FROM   Leads
WHERE  Status = 'New';
Index chỉ chứa Status và khoá gom cụm. Để lấy CompanyName và EstimatedValue, database phải quay về index gom cụm cho mỗi dòng — gọi là key lookup.
Với 10 dòng thì không sao. Với 50.000 dòng, đó là 50.000 lần tra cứu ngẫu nhiên, và optimizer thường bỏ index để quét toàn bảng — vì quét tuần tự rẻ hơn.
-- Covering index — INCLUDE các cột chỉ để đọc
CREATE INDEX IX_Leads_Status_Covering
    ON Leads (Status, CreatedAt DESC)
    INCLUDE (LeadId, CompanyName, EstimatedValue, AssignedToUserId);
Giờ index chứa mọi cột truy vấn cần — không có key lookup nào.
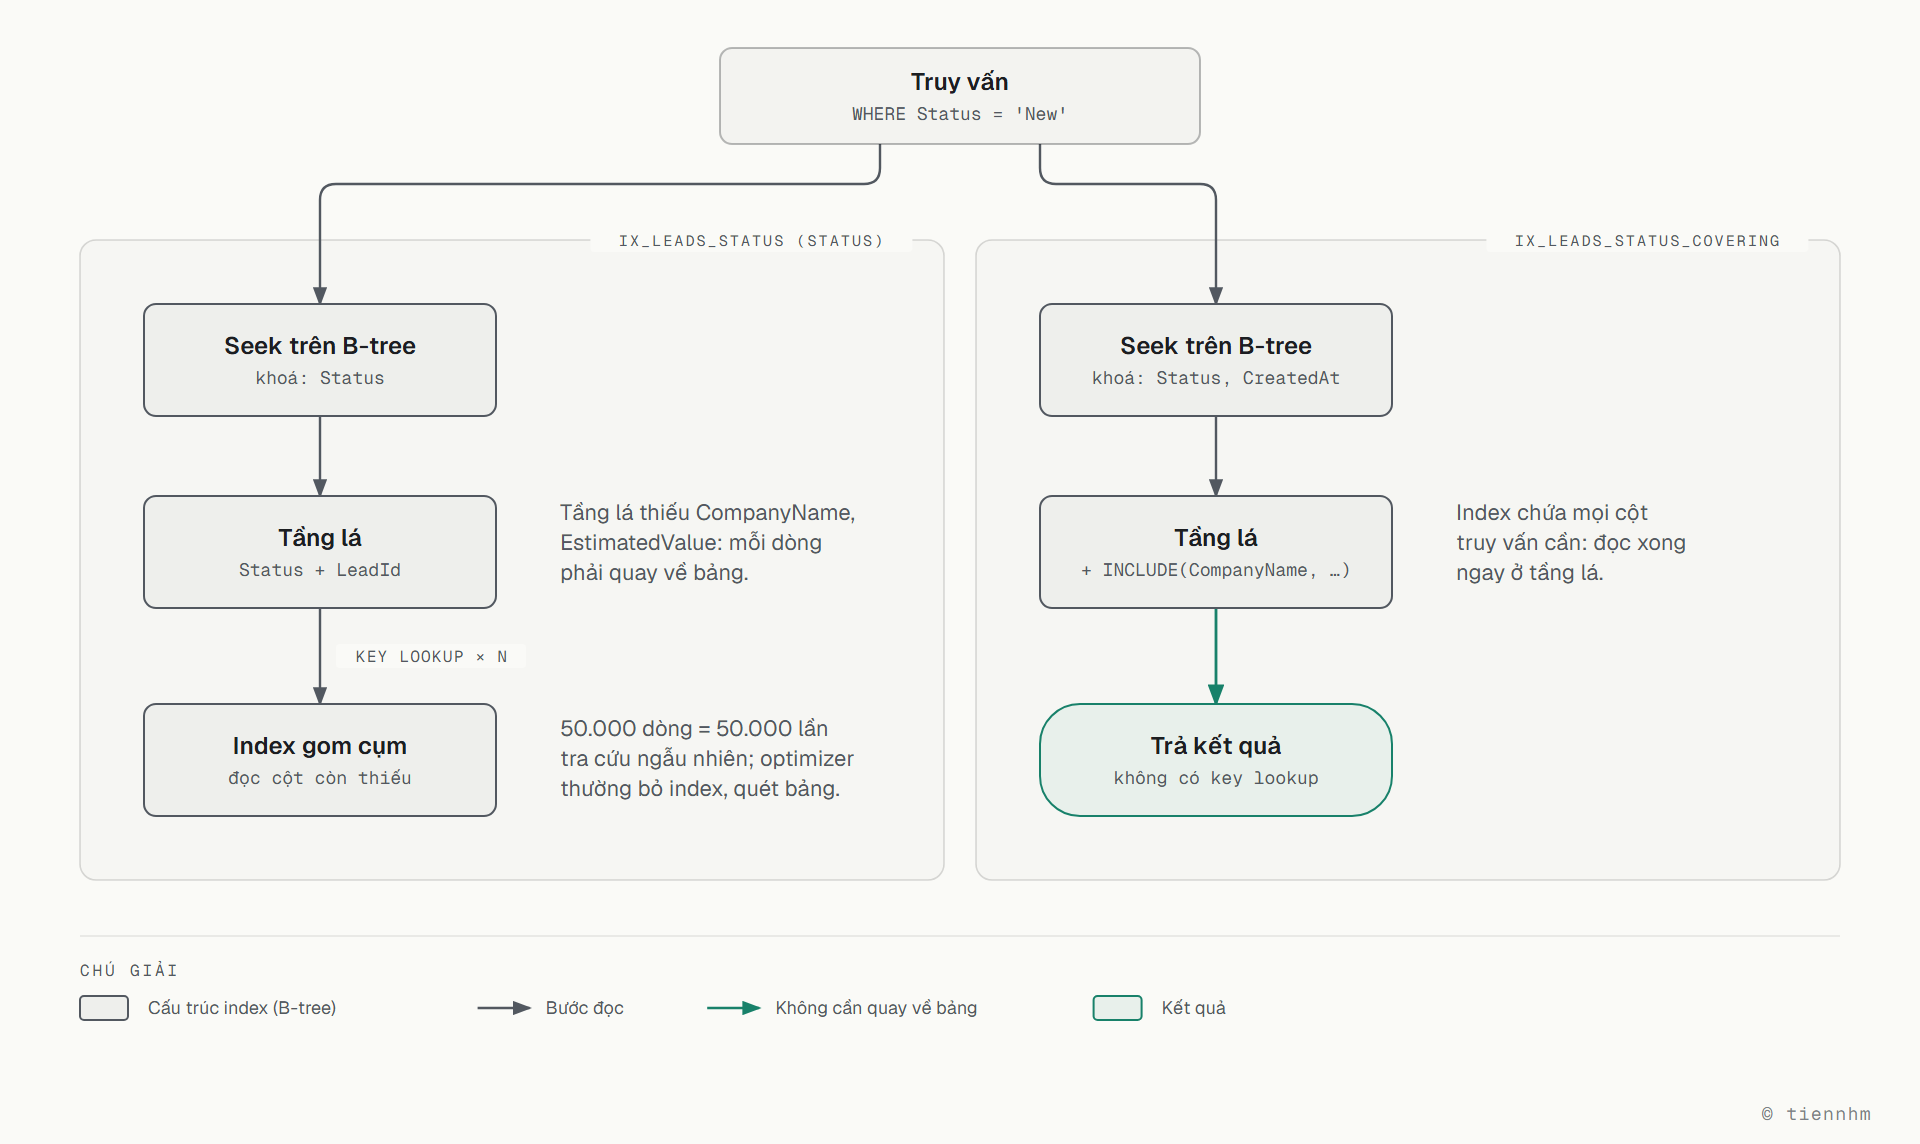
INCLUDE khác cột khoá thế nào?
| Cột khoá | Cột INCLUDE | |
|---|---|---|
| Nằm ở | Mọi tầng B-tree | Chỉ tầng lá |
| Dùng để seek / sort | Có | Không |
| Tốn dung lượng | Nhiều hơn | Ít hơn |
| Giới hạn | 16 cột, 900 byte | Gần như không |
Quy tắc: cột xuất hiện trong WHERE, JOIN, ORDER BY → cột khoá. Cột chỉ xuất hiện trong SELECT → INCLUDE.
PostgreSQL có INCLUDE từ v11; trước đó phải đưa hết vào cột khoá.
Đừng covering mọi thứ. Một index INCLUDE 15 cột gần như là bản sao của bảng — nó làm mọi UPDATE chậm và chiếm gấp đôi dung lượng.
12.4.5 — Filtered index
-- 95% truy vấn chỉ quan tâm lead chưa kết thúc
CREATE INDEX IX_Leads_Active
    ON Leads (AssignedToUserId, CreatedAt DESC)
    WHERE Status NOT IN ('Won', 'Lost');
Nếu 80% lead đã Won/Lost, index này chỉ bằng 1/5 kích thước — nhỏ hơn, nằm gọn trong bộ nhớ, và cập nhật rẻ hơn.
Điều kiện WHERE của truy vấn phải khớp hoặc hẹp hơn điều kiện của index; nếu không optimizer bỏ qua nó.
Ứng dụng quan trọng nhất là ép duy nhất trên tập con — soft delete ở bài 12.1:
CREATE UNIQUE INDEX UQ_Users_Email_Active
    ON Users(Email) WHERE DeletedAt IS NULL;
12.4.6 — Cái giá của index
Mỗi index thêm vào phải trả:
| Chi phí | Chi tiết |
|---|---|
| Ghi chậm hơn | Mỗi INSERT phải cập nhật mọi index |
| Dung lượng | Index có thể lớn hơn bảng khi cộng lại |
| Bộ nhớ | Index chiếm buffer pool, đẩy dữ liệu nóng ra |
| Sao lưu, khôi phục | Lâu hơn |
| Khoá | Cập nhật index mở rộng phạm vi khoá |
Bảng 10 index nghĩa là một INSERT thành 11 thao tác ghi. Nhiều hệ thống chậm vì thừa index.
Tìm index không dùng:
-- SQL Server
SELECT OBJECT_NAME(s.object_id) AS TableName, i.name AS IndexName,
       s.user_seeks, s.user_scans, s.user_lookups, s.user_updates
FROM   sys.dm_db_index_usage_stats s
JOIN   sys.indexes i ON i.object_id = s.object_id AND i.index_id = s.index_id
WHERE  s.database_id = DB_ID()
  AND  i.is_primary_key = 0
  AND  s.user_seeks + s.user_scans + s.user_lookups = 0    -- chua bao gio DOC
  AND  s.user_updates > 0                                  -- nhưng vẫn phải GHI
ORDER  BY s.user_updates DESC;
Index xuất hiện ở đây là chi phí thuần: tốn công duy trì mà không ai dùng.
Lưu ý: thống kê này reset khi restart SQL Server, nên phải thu thập ít nhất một chu kỳ nghiệp vụ đầy đủ — đừng xoá index chỉ sau hai ngày, vì có thể nó phục vụ báo cáo cuối tháng.
Index trùng lặp cũng đáng tìm: (A, B) và (A) — cái thứ hai gần như luôn thừa, vì index đầu đã phục vụ mọi truy vấn chỉ dùng A.
Khoá ngoại không có index là vấn đề ngược lại: SQL Server không tự tạo index cho khoá ngoại (khác với PostgreSQL cũng vậy). Mỗi lần xoá dòng cha, database phải quét bảng con để kiểm tra tham chiếu.
CREATE INDEX IX_Contacts_CustomerId ON Contacts(CustomerId);12.4.7 — Rà lại code của bạn
Danh sách rà soát index
- Mọi bảng đều có index gom cụm, không có heap ngoài ý muốn.
- Thứ tự cột trong composite index: bằng trước, khoảng sau.
- Không có truy vấn nào bọc cột lọc trong hàm.
- Chuỗi cần tìm không phân biệt hoa thường được chuẩn hoá khi ghi.
- Truy vấn nóng có covering index, không còn key lookup lớn.
- Cột chỉ để đọc nằm trong INCLUDE, không nằm ở cột khoá.
- Không có index nào INCLUDE gần như toàn bộ bảng.
- Mọi khoá ngoại đều có index.
- Đã rà index không được dùng qua ít nhất một chu kỳ nghiệp vụ đầy đủ.
- Không có index trùng lặp kiểu (A,B) và (A).
- Ràng buộc duy nhất trên tập con dùng filtered index.
Bài tập áp dụng
Bài 1 — Hàm bọc quanh cột làm index vô dụng
Trên bảng 1 triệu dòng có index trên CreatedAt, chạy WHERE YEAR(CreatedAt) = 2026 và WHERE CreatedAt >= '2026-01-01' AND CreatedAt < '2027-01-01'. So sánh execution plan và số lần đọc trang.
Tiêu chí hoàn thành: bạn giải thích được vì sao database không thể tự viết lại hàm thành khoảng, dù kết quả hai cách là như nhau.
Gợi ý và lời giải — Bài 1
Gợi ý. Index là một cấu trúc đã sắp xếp theo giá trị cột. Hãy nghĩ xem YEAR(x) = 2026 cho biết gì về vị trí của x trong cấu trúc đó.
Lời giải — hai truy vấn:
CREATE INDEX IX_Leads_CreatedAt ON Leads(CreatedAt);
SET STATISTICS IO ON;

-- KHÔNG SARGable — hàm bọc quanh CỘT
SELECT COUNT(*) FROM Leads WHERE YEAR(CreatedAt) = 2026;|--Index Scan(OBJECT:([IX_Leads_CreatedAt]),
WHERE:(datepart(year,[CreatedAt])=(2026)))
Table 'Leads'. logical reads 2847-- SARGable — cột đứng một mình
SELECT COUNT(*) FROM Leads
WHERE CreatedAt >= '2026-01-01' AND CreatedAt < '2027-01-01';|--Index Seek(OBJECT:([IX_Leads_CreatedAt]),
SEEK:([CreatedAt] >= '2026-01-01' AND [CreatedAt] < '2027-01-01'))
Table 'Leads'. logical reads 412Quét toàn index so với nhảy thẳng tới khoảng cần: gần 7 lần đọc trang. Với bảng lớn hơn, tỷ lệ này còn giãn ra.
Vì sao database không tự viết lại được. Index lưu các giá trị CreatedAt đã sắp xếp. Để dùng nó, optimizer cần biết khoảng giá trị cần tìm — tức là một điểm bắt đầu và một điểm kết thúc trong cấu trúc đã sắp xếp.
CreatedAt >= A AND CreatedAt < B nói thẳng điều đó.
YEAR(CreatedAt) = 2026 thì không. Nó nói về kết quả của một hàm, và optimizer không biết hàm đó ánh xạ ngược ra khoảng nào. Nó chỉ có một cách chắc chắn đúng: lấy từng giá trị, tính YEAR(), rồi so. Tức là đọc hết.
Về lý thuyết, YEAR là hàm đơn điệu nên viết lại được — và SQL Server có làm điều đó cho một số trường hợp rất hẹp. Nhưng quy tắc chung thì không, vì optimizer phải đúng với mọi hàm, kể cả hàm người dùng tự viết mà nó không biết gì về hành vi. Nên nó chọn cách an toàn.
Ba dạng phá index hay gặp nhất:
-- 1. Hàm trên cột
WHERE YEAR(CreatedAt) = 2026
WHERE UPPER(Email) = '[email protected]'
WHERE CAST(CustomerId AS NVARCHAR) = '42'

-- 2. Tính toán trên cột
WHERE Total * 1.1 > 1000000          -- viết lại: Total > 1000000 / 1.1

-- 3. Wildcard ở đầu chuỗi
WHERE Name LIKE N'%Phát'             -- không biết bắt đầu tìm từ đâu
Viết lại tương ứng:
WHERE CreatedAt >= '2026-01-01' AND CreatedAt < '2027-01-01'
WHERE Email = '[email protected]'       -- chuẩn hoá khi GHI, xem bài 12.3
WHERE CustomerId = 42
WHERE Total > 909090.91
WHERE Name LIKE N'Phát%'             -- tiền tố thì dùng được index
Khi thật sự cần truy vấn theo kết quả hàm, đặt index lên chính biểu thức:
-- SQL Server: cột tính toán rồi index lên nó
ALTER TABLE Leads ADD CreatedYear AS YEAR(CreatedAt) PERSISTED;
CREATE INDEX IX_Leads_CreatedYear ON Leads(CreatedYear);-- PostgreSQL: index trên biểu thức, không cần thêm cột
CREATE INDEX idx_leads_created_year ON leads (EXTRACT(YEAR FROM created_at));Cái bẫy trong EF Core. Viết LINQ theo thói quen rất dễ sinh ra hàm trên cột:
// SAI — sinh DATEPART(year, [l].[CreatedAt]) = 2026
_db.Leads.Where(l => l.CreatedAt.Year == 2026)

// ĐÚNG
var from = new DateTime(2026, 1, 1);
var to   = new DateTime(2027, 1, 1);
_db.Leads.Where(l => l.CreatedAt >= from && l.CreatedAt < to)
Bật log SQL của EF Core khi phát triển là cách rẻ nhất để bắt những chỗ này — xem bài 13.1.
Cách rà soát nhanh: tìm CONVERT_IMPLICIT, Scan và tên hàm trong execution plan của các truy vấn chậm nhất. Mỗi lần thấy một hàm áp lên tên cột là một index đang bị vô hiệu hoá.
Bài 2 — Key lookup và ngưỡng optimizer bỏ index
Tạo index chỉ trên Status, chạy truy vấn SELECT nhiều cột với 50.000 dòng khớp, và xem optimizer có dùng index không. Thêm INCLUDE và so sánh.
Tiêu chí hoàn thành: bạn giải thích được vì sao optimizer cố tình bỏ qua một index đang tồn tại và phù hợp.
Gợi ý và lời giải — Bài 2
Gợi ý. Index chỉ chứa Status và khoá chính. Những cột khác trong SELECT phải lấy từ đâu?
Lời giải — index hẹp:
CREATE INDEX IX_Leads_Status ON Leads(Status);

SET STATISTICS IO ON;

SELECT Id, Name, Value, CreatedAt, OwnerId
FROM   Leads
WHERE Status = N'New'; -- khớp 50.000 / 1.000.000 dòng|--Clustered Index Scan(OBJECT:([PK_Leads]), WHERE:([Status]=N'New'))
Table 'Leads'. logical reads 8921Optimizer bỏ qua IX_Leads_Status và quét thẳng bảng.
Vì sao nó cố tình làm vậy. Index IX_Leads_Status chỉ chứa hai thứ: Status và khoá chính Id. Truy vấn cần thêm Name, Value, CreatedAt, OwnerId — những cột không có trong index.
Nên nếu dùng index, SQL Server phải:
1. Seek vào index, lấy 50.000 giá trị Id
2. Với MỖI Id, nhảy về clustered index lấy các cột còn lại   <- key lookup
Mỗi key lookup là một lần truy cập ngẫu nhiên vào cây B-tree, tốn khoảng 3–4 lần đọc trang. 50.000 lookup là khoảng 150.000–200.000 lần đọc — nhiều hơn hẳn so với 8.921 lần đọc khi quét tuần tự cả bảng.
Optimizer ước lượng được điều đó và chọn phương án rẻ hơn. Đây không phải nó "không thấy index"; nó thấy, tính, và kết luận rằng dùng index đắt hơn.
Ngưỡng này gọi là tipping point, và nó thấp hơn nhiều người tưởng: thường chỉ khoảng 1–2% số dòng của bảng. Vượt ngưỡng đó, quét tuần tự thắng.
Khớp     50 dòng / 1.000.000  (0,005%)  -> dùng index + lookup
Khớp  5.000 dòng / 1.000.000  (0,5%)    -> dùng index + lookup
Khớp 50.000 dòng / 1.000.000  (5%)      -> QUÉT BẢNG
Thêm INCLUDE để index tự chứa đủ dữ liệu:
CREATE INDEX IX_Leads_Status_Covering
    ON Leads(Status)
INCLUDE (Name, Value, CreatedAt, OwnerId);|--Index Seek(OBJECT:([IX_Leads_Status_Covering]), SEEK:([Status]=N'New'))
Table 'Leads'. logical reads 487Từ 8.921 xuống 487 — gần 18 lần. Không còn lookup nào vì mọi cột cần đều nằm sẵn trong index. Đây gọi là covering index.
Khác biệt giữa cột khoá và cột INCLUDE:
Cột khoá (...) | Cột INCLUDE (...) | |
|---|---|---|
| Được sắp xếp | Có | Không |
Dùng để SEEK | Có | Không |
Dùng để ORDER BY | Có | Không |
| Nằm ở | Mọi tầng của B-tree | Chỉ tầng lá |
| Chi phí dung lượng | Cao hơn | Thấp hơn |
Vì INCLUDE chỉ nằm ở tầng lá, nó không làm phình các tầng trên của cây — nên thêm cột vào INCLUDE rẻ hơn nhiều so với thêm vào khoá.
Quy tắc thực dụng:
Cột dùng để LỌC hoặc SẮP XẾP  ->  đặt trong khoá
Cột chỉ để ĐỌC ra              ->  đặt trong INCLUDE
Và đừng lạm dụng. Một covering index cho mỗi truy vấn nghe hấp dẫn, nhưng mỗi index là một cấu trúc phải cập nhật ở mọi INSERT, UPDATE, DELETE — chi phí đó đo được ở bài 3. Chỉ tạo covering index cho những truy vấn thật sự quan trọng và chạy thường xuyên.
Cách tìm ứng viên:
SELECT TOP 20
       mid.statement, migs.avg_user_impact,
       migs.user_seeks + migs.user_scans AS uses,
       mid.equality_columns, mid.inequality_columns, mid.included_columns
FROM   sys.dm_db_missing_index_groups mig
JOIN   sys.dm_db_missing_index_group_stats migs ON migs.group_handle = mig.index_group_handle
JOIN   sys.dm_db_missing_index_details  mid     ON mig.index_handle  = mid.index_handle
ORDER  BY migs.avg_user_impact * (migs.user_seeks + migs.user_scans) DESC;
Đây là gợi ý, không phải lệnh. SQL Server đề xuất index cho từng truy vấn riêng lẻ mà không nhìn tổng thể, nên nó hay đề xuất nhiều index gần trùng nhau. Hãy gộp lại trước khi tạo.
Bài 3 — Cái giá của index khi ghi
Đo thời gian chèn 100.000 dòng vào bảng có 1 index, rồi vào bảng giống hệt có 8 index. So sánh.
Tiêu chí hoàn thành: bạn nêu được con số và rút ra được nguyên tắc về số lượng index nên có trên một bảng ghi nhiều.
Gợi ý và lời giải — Bài 3
Gợi ý. Mỗi index là một cây B-tree riêng. Một dòng mới phải được chèn vào mọi cây.
Lời giải — hai bảng:
CREATE TABLE LeadsFew (
    Id INT IDENTITY PRIMARY KEY,
    Name NVARCHAR(200), Email NVARCHAR(256), Status NVARCHAR(50),
    Value DECIMAL(18,2), OwnerId INT, TenantId INT,
    CreatedAt DATETIME2(3), UpdatedAt DATETIME2(3)
);

CREATE TABLE LeadsMany (   -- cấu trúc y hệt
    Id INT IDENTITY PRIMARY KEY,
    Name NVARCHAR(200), Email NVARCHAR(256), Status NVARCHAR(50),
    Value DECIMAL(18,2), OwnerId INT, TenantId INT,
    CreatedAt DATETIME2(3), UpdatedAt DATETIME2(3)
);

CREATE INDEX IX1 ON LeadsMany(Email);
CREATE INDEX IX2 ON LeadsMany(Status);
CREATE INDEX IX3 ON LeadsMany(OwnerId);
CREATE INDEX IX4 ON LeadsMany(TenantId, Status);
CREATE INDEX IX5 ON LeadsMany(CreatedAt);
CREATE INDEX IX6 ON LeadsMany(UpdatedAt);
CREATE INDEX IX7 ON LeadsMany(Value) INCLUDE (Name, Status);SET STATISTICS TIME ON;
-- chèn 100.000 dòng vào từng bảngKết quả điển hình:
| 1 index (khoá chính) | 8 index | |
|---|---|---|
| Thời gian chèn | ~3,1 giây | ~19,4 giây |
| Logical writes | ~4.200 | ~38.500 |
| Dung lượng bảng | 18 MB | 71 MB |
Chèn chậm hơn khoảng 6 lần và tốn gấp 4 lần dung lượng.
Vì sao. Mỗi INSERT phải:
1. Ghi dòng vào clustered index
2. Ghi một mục vào MỖI nonclustered index — 7 lần nữa
3. Với mỗi cây, có thể phải tách trang nếu trang đích đã đầy
4. Mọi thay đổi đều được ghi vào transaction log
Và UPDATE còn tệ hơn: sửa một cột có mặt trong ba index là ba cây phải cập nhật, mỗi cây có thể cần xoá rồi chèn lại nếu giá trị khoá đổi.
Nguyên tắc rút ra: index là một khoản đầu tư, không phải một thứ miễn phí. Mỗi index nên trả lời được câu hỏi "truy vấn nào dùng nó, chạy bao nhiêu lần một ngày?". Không trả lời được thì nên xoá.
Tìm index không ai dùng:
SELECT OBJECT_NAME(i.object_id)          AS TableName,
       i.name                            AS IndexName,
       s.user_seeks + s.user_scans + s.user_lookups AS Reads,
       s.user_updates                    AS Writes
FROM   sys.indexes i
LEFT JOIN sys.dm_db_index_usage_stats s
       ON s.object_id = i.object_id AND s.index_id = i.index_id
      AND s.database_id = DB_ID()
WHERE  i.type_desc = 'NONCLUSTERED'
  AND  OBJECTPROPERTY(i.object_id, 'IsUserTable') = 1
  AND  ISNULL(s.user_seeks + s.user_scans + s.user_lookups, 0) = 0
  AND  ISNULL(s.user_updates, 0) > 1000                  -- nhưng vẫn phải GHI
ORDER  BY s.user_updates DESC;
Mỗi dòng trả về là một index chỉ tốn chi phí: không truy vấn nào đọc nó, nhưng mọi lần ghi đều phải cập nhật nó.
Lưu ý: thống kê này được đặt lại khi SQL Server khởi động lại, nên hãy xem sau khi hệ thống đã chạy ít nhất vài tuần — đủ để bao gồm cả những báo cáo chỉ chạy cuối tháng.
Ngưỡng thực dụng theo loại bảng:
| Loại bảng | Số index hợp lý |
|---|---|
| Ghi rất nhiều (log, event, outbox) | 1–2 |
| Nghiệp vụ thông thường | 3–5 |
| Chủ yếu đọc (bảng tra cứu, báo cáo) | 5–10 |
Và trước khi thêm index thứ sáu, hãy kiểm tra xem có index nào đã bao phủ nó chưa. Index (TenantId, Status) đã phục vụ được truy vấn chỉ lọc theo TenantId — thêm một index riêng cho TenantId là thừa. Quy tắc: index trên (A, B) dùng được cho truy vấn lọc theo A, nhưng không dùng được cho truy vấn chỉ lọc theo B.
Tự kiểm tra
Vì sao thứ tự cột trong composite index quan trọng?
Vì index chỉ dùng được cho các tiền tố trái liên tục, giống danh bạ sắp theo họ rồi tên: tìm theo họ thì nhanh, tìm theo tên thôi thì phải quét hết. Index trên Status và CreatedAt phục vụ truy vấn lọc theo Status nhưng vô dụng cho truy vấn chỉ lọc theo CreatedAt.
Đặt cột nào trước trong composite index?
Cột dùng với so sánh bằng trước cột dùng với khoảng, và trong các cột bằng thì cột lọc mạnh hơn đặt trước. Sau một cột dùng khoảng thì mọi cột tiếp theo không còn dùng để seek nữa, nên cột khoảng phải đứng cuối.
SARGable nghĩa là gì?
Là điều kiện mà database dùng được index để seek. Quy tắc duy nhất cần nhớ là cột phải đứng một mình ở một vế; bọc nó trong hàm buộc database tính hàm cho mọi dòng trước khi so sánh, tức quét toàn bảng dù index tồn tại. Đây là nguyên nhân phổ biến nhất của việc đã tạo index rồi mà vẫn chậm.
Key lookup là gì và vì sao nó thành vấn đề?
Là việc quay về index gom cụm để lấy những cột không có trong index, cho mỗi dòng khớp. Với vài dòng thì không sao, nhưng với hàng chục nghìn dòng thì optimizer thường bỏ index để quét toàn bảng vì quét tuần tự rẻ hơn tra cứu ngẫu nhiên nhiều lần.
INCLUDE khác cột khoá thế nào?
Cột khoá nằm ở mọi tầng B-tree và dùng được để seek và sắp xếp; cột INCLUDE chỉ nằm ở tầng lá, không seek được nhưng tốn ít dung lượng hơn và gần như không giới hạn số cột. Cột trong WHERE, JOIN, ORDER BY thì làm cột khoá; cột chỉ trong SELECT thì INCLUDE.
Index thừa gây hại thế nào?
Mỗi INSERT phải cập nhật mọi index nên bảng 10 index biến một lần ghi thành 11 thao tác. Ngoài ra index chiếm dung lượng, chiếm buffer pool đẩy dữ liệu nóng ra, làm sao lưu lâu hơn và mở rộng phạm vi khoá. Nhiều hệ thống chậm vì thừa index chứ không phải thiếu.
Kết luận
Ba điều đáng nhớ nhất:
- Thứ tự cột quyết định index có dùng được hay không. Bằng trước, khoảng sau.
- Bọc cột trong hàm là vô hiệu hoá index. Viết lại điều kiện thành dạng khoảng.
- Index không miễn phí. Rà và xoá index không ai dùng.
Tham khảo
- SQL Server index architecture and design guide
- Create indexes with included columns
- Create filtered indexes
- PostgreSQL — Indexes
Điều hướng
- Bài trước: 12.3 — Queries nâng cao
- Bài tiếp theo: 12.5 — Query Optimization
- Về module: Trang mục lục
Bài liên quan
- Vì sao EF Core bắn 201 query cho 1 màn hình danh sách? Cách sửa N+1 — Một màn hình 200 dòng mà log SQL ghi 201 câu lệnh là dấu hiệu của N+1 query.