15.5 - Linux VPS Deployment
Tóm tắt: Một VPS 4GB chạy được ứng dụng .NET phục vụ hàng nghìn người dùng — và nó rẻ hơn nhiều so với PaaS. Cái giá là bạn tự lo bảo mật, cập nhật và giám sát. Ba việc bắt buộc trước khi đưa bất cứ thứ gì lên: tắt đăng nhập bằng mật khẩu qua SSH (server có IP công khai bị dò mật khẩu trong vài phút sau khi bật), bật tường lửa với danh sách trắng, và bật cập nhật bảo mật tự động. Về ứng dụng, sai lầm phổ biến nhất là quên
UseForwardedHeaders— thiếu nó, ASP.NET Core thấy mọi request là HTTP từ IP của Nginx, làmUseHttpsRedirectionchuyển hướng vô tận và rate limit theo IP chặn nhầm tất cả như một.
Mục tiêu bài học
Sau bài này bạn có thể:
- Làm cứng một VPS mới trước khi triển khai.
- Cấu hình Nginx làm reverse proxy cho ASP.NET Core.
- Bật TLS tự động gia hạn.
- Deploy có thể rollback.
- Giám sát những thứ thường làm chết VPS.
Nội dung bài học
15.5.1 — Làm cứng server
# 1. Cập nhật và tạo user không phải root
sudo apt update && sudo apt upgrade -y
sudo adduser deploy && sudo usermod -aG sudo,docker deploy

# 2. Copy khoá SSH từ máy của bạn
ssh-copy-id deploy@<ip># 3. Tắt đăng nhập bằng mật khẩu — /etc/ssh/sshd_config
PermitRootLogin no
PasswordAuthentication no
PubkeyAuthentication yes
sudo systemctl restart sshCAUTION
Kiểm tra trước khi đóng phiên
Mở một phiên SSH mới và xác nhận đăng nhập được trước khi đóng phiên hiện tại. Cấu hình sai cộng đóng phiên là mất quyền truy cập server.
Vì sao bắt buộc: một server có IP công khai bắt đầu nhận hàng nghìn lượt dò mật khẩu SSH mỗi ngày trong vòng vài phút sau khi bật. Khoá SSH loại bỏ hoàn toàn nhóm tấn công đó.
# 4. Tường lửa — MẶC ĐỊNH chặn, chỉ mở cái cần
sudo ufw default deny incoming
sudo ufw default allow outgoing
sudo ufw allow OpenSSH
sudo ufw allow 80/tcp
sudo ufw allow 443/tcp
sudo ufw enable

# 5. Fail2ban — chan IP do mat khau
sudo apt install -y fail2ban
sudo systemctl enable --now fail2ban

# 6. Cập nhật bảo mật tự động
sudo apt install -y unattended-upgrades
sudo dpkg-reconfigure -plow unattended-upgrades
Đừng mở cổng 1433, 5432 hay 6379. Database và cache chỉ cần truy cập được từ trong mạng Docker (bài 15.3). Cần kết nối từ máy dev thì dùng SSH tunnel:
ssh -L 1433:localhost:1433 deploy@<ip>15.5.2 — Nginx làm reverse proxy
# /etc/nginx/sites-available/crm-api
server {
    listen 80;
    server_name api.example.com;

    client_max_body_size 20M;          # khop voi gioi han upload cua ung dung

    location / {
        proxy_pass http://127.0.0.1:8080;
        proxy_http_version 1.1;

        # BẮT BUỘC cho WebSocket và SignalR
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";

        # BAT BUOC cho UseForwardedHeaders
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        proxy_read_timeout 3600s;      # không cắt kết nối dài
        proxy_buffering off;           # cho streaming response
    }
}
Bốn dòng đáng giải thích:
client_max_body_size mặc định 1MB. Ứng dụng cấu hình 20MB nhưng Nginx chặn ở 1MB, và client nhận 413 từ Nginx — không có gì trong log ứng dụng (bài 9.5).
Upgrade và Connection bắt buộc cho WebSocket; thiếu chúng thì SignalR luôn rơi về long polling mà không có lỗi nào (bài 11.10).
proxy_read_timeout mặc định 60 giây — cắt kết nối SignalR mỗi phút.
proxy_buffering off cần khi bạn stream response (export CSV lớn); có buffering thì Nginx giữ cả response rồi mới gửi.
Phía ASP.NET Core:
builder.Services.Configure<ForwardedHeadersOptions>(options =>
{
    options.ForwardedHeaders = ForwardedHeaders.XForwardedFor | ForwardedHeaders.XForwardedProto;
    options.KnownProxies.Clear();
    options.KnownNetworks.Clear();
    options.KnownProxies.Add(IPAddress.Parse("127.0.0.1"));   // CHI tin Nginx cuc bo
});

var app = builder.Build();
app.UseForwardedHeaders();        // TRƯỚC mọi middleware khác
KnownProxies là phần bảo mật: không giới hạn, bất kỳ ai cũng gửi X-Forwarded-For giả để vượt rate limit theo IP hoặc giả mạo địa chỉ trong log (bài viết về forward header).
15.5.3 — TLS
sudo apt install -y certbot python3-certbot-nginx
sudo certbot --nginx -d api.example.com

# Kiểm tra gia hạn tự động
sudo systemctl status certbot.timer
sudo certbot renew --dry-run
Certbot tự sửa cấu hình Nginx, thêm chuyển hướng HTTP sang HTTPS, và cài một timer gia hạn.
Kiểm tra certbot renew --dry-run ngay sau khi cài. Chứng chỉ Let's Encrypt hết hạn sau 90 ngày, và gia hạn thất bại im lặng là nguyên nhân phổ biến của "trang web báo không an toàn" vào một buổi sáng.
Thêm hai dòng vào Nginx sau khi có chứng chỉ:
add_header Strict-Transport-Security "max-age=31536000; includeSubDomains" always;
add_header X-Content-Type-Options "nosniff" always;
HSTS nên đặt ở một chỗ — hoặc Nginx hoặc ứng dụng, không cả hai (bài 10.10).
Và khi đã có Nginx lo TLS, tắt UseHttpsRedirection trong ứng dụng — Nginx đã chuyển hướng, và ứng dụng chỉ nghe HTTP nội bộ.
15.5.4 — Deploy có rollback
#!/usr/bin/env bash
# /opt/crm/deploy.sh
set -euo pipefail

TAG="${1:?Usage: deploy.sh <tag>}"
cd /opt/crm

# 1. Lưu lại tag hiện tại để rollback
CURRENT=$(grep '^TAG=' .env | cut -d= -f2)
echo "Dang chay: $CURRENT -> trien khai: $TAG"

# 2. Kéo image TRƯỚC khi dừng gì
docker compose pull

# 3. Đổi tag và khởi động
sed -i "s/^TAG=.*/TAG=$TAG/" .env
docker compose -f compose.yaml -f compose.prod.yaml up -d

# 4. Cho healthy
for i in {1..30}; do
    if curl -fsS http://127.0.0.1:8080/health/ready > /dev/null; then
        echo "Triển khai thành công: $TAG"
        docker image prune -f
        exit 0
    fi
    sleep 2
done

# 5. Thất bại -> ROLLBACK
echo "Health check thất bại, rollback về $CURRENT"
sed -i "s/^TAG=.*/TAG=$CURRENT/" .env
docker compose -f compose.yaml -f compose.prod.yaml up -d
exit 1
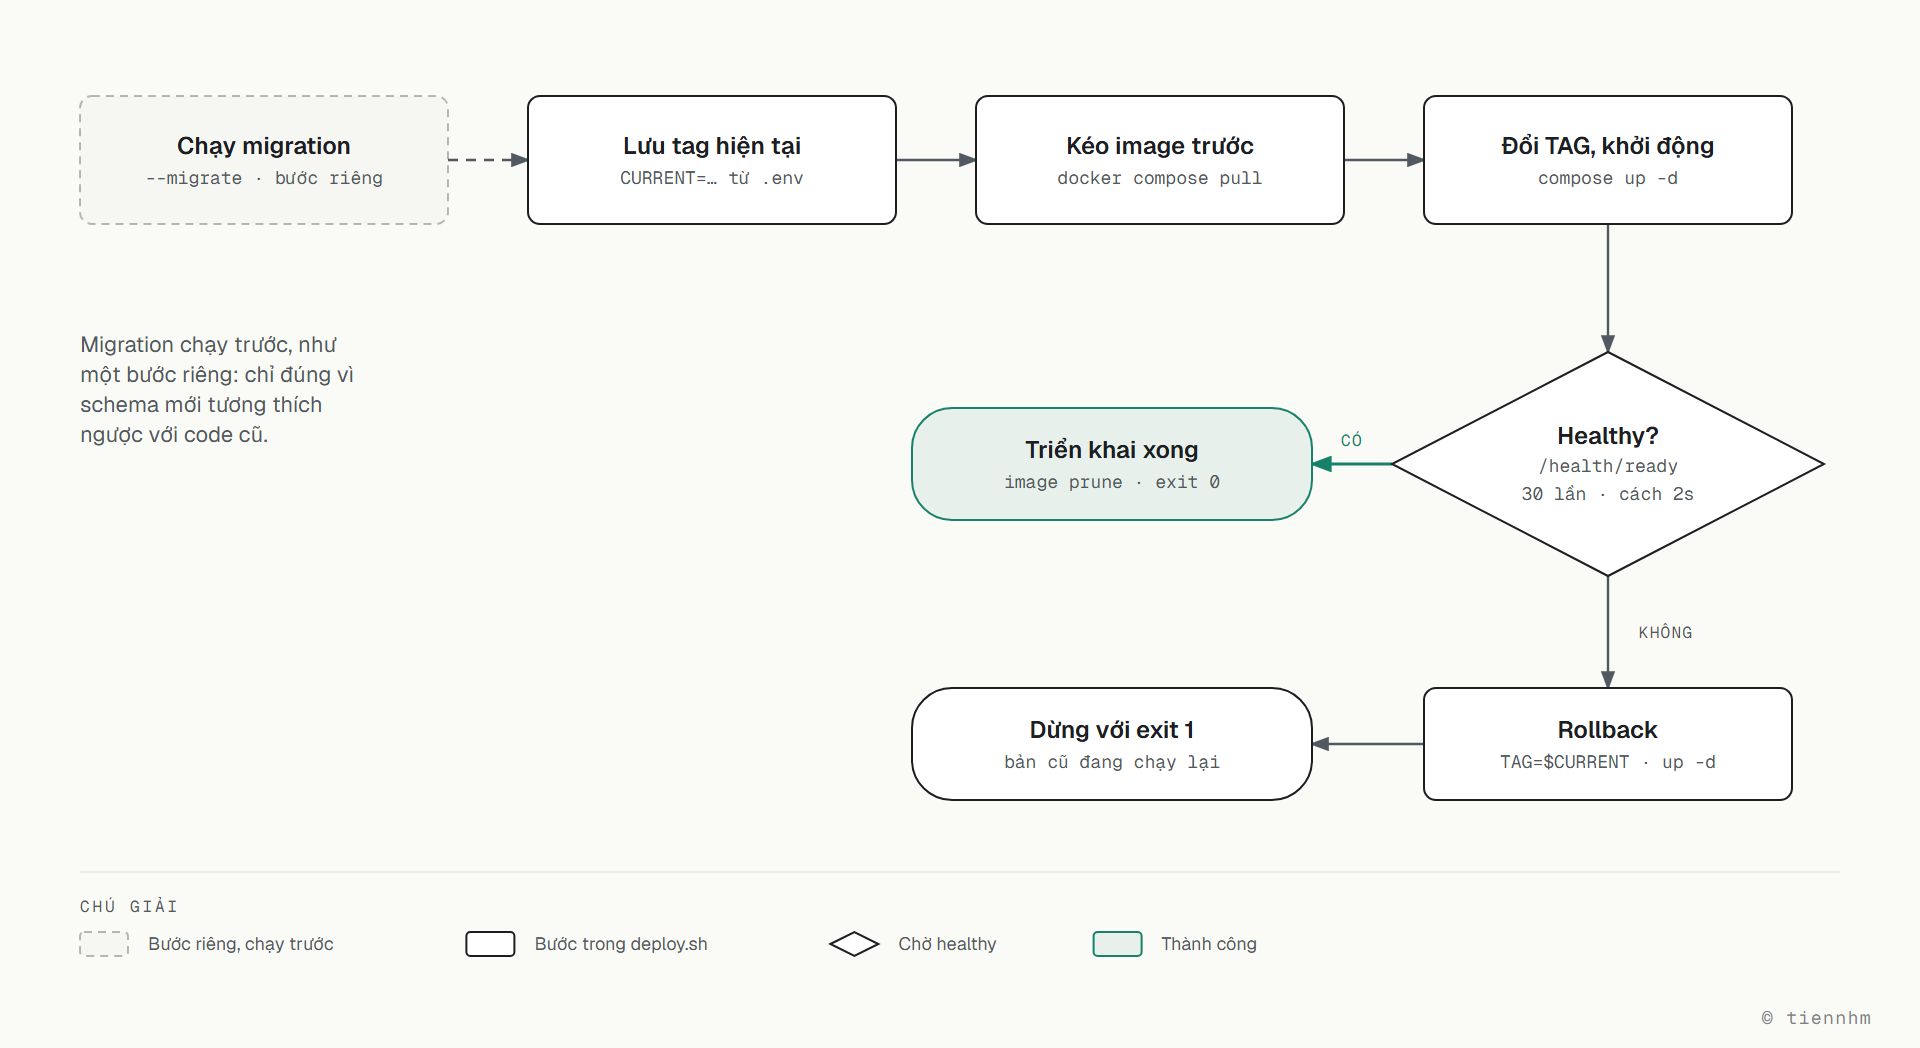
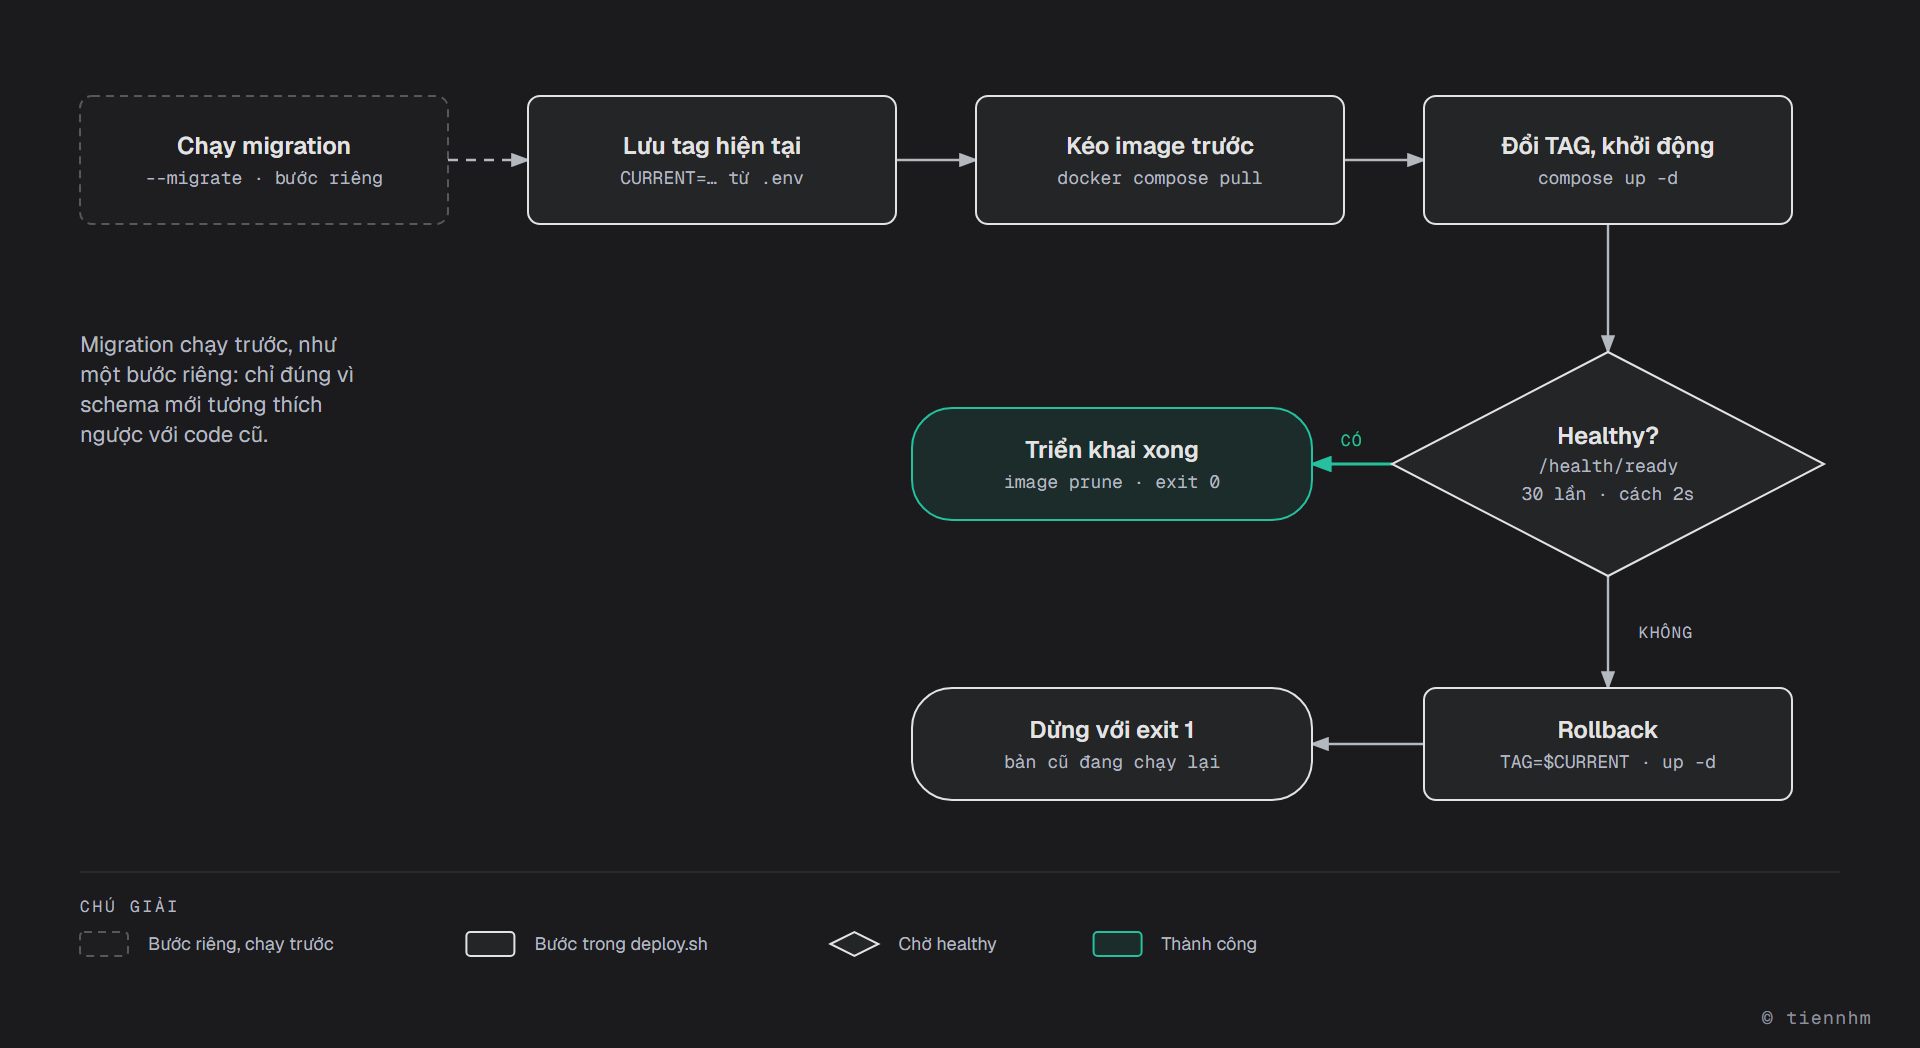
Bốn điều làm nó an toàn: set -euo pipefail dừng ngay khi có lỗi; pull trước khi dừng gì (lỗi mạng không làm chết dịch vụ); chờ healthy thay vì giả định thành công; và rollback tự động khi health check thất bại.
Chạy migration trước deploy, như một bước riêng (bài 12.8):
docker compose run --rm api dotnet CrmApi.dll --migrate
./deploy.sh "$TAG"
Thứ tự này chỉ đúng vì migration tương thích ngược — schema mới chạy được với code cũ đang phục vụ.
Toàn bộ luồng, kể cả bước migration chạy trước:
15.5.5 — Giám sát những thứ làm chết VPS
Ba thứ phổ biến nhất, theo thứ tự:
1. Đầy đĩa. Nguyên nhân gần như luôn là log Docker hoặc image cũ.
df -h
docker system df
du -sh /var/lib/docker/containers/*/*.log | sort -h | tail# Gioi han log — BAT BUOC
logging:
driver: json-file
options:
max-size: "10m"
max-file: "3"# Don image cu hang tuan
0 3 * * 0 docker image prune -af --filter "until=168h"2. Hết bộ nhớ. Container bị OOM kill (bài 15.1).
# Kiểm tra đã từng bị OOM chưa
dmesg | grep -i "killed process"
docker inspect crm-api | grep -i oomkilled
Thêm swap là lưới an toàn (không thay thế được việc đặt giới hạn đúng):
sudo fallocate -l 2G /swapfile && sudo chmod 600 /swapfile
sudo mkswap /swapfile && sudo swapon /swapfile
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab
3. Chứng chỉ hết hạn. Xem mục 15.5.3.
Giám sát tối thiểu với một script cron:
#!/usr/bin/env bash
DISK=$(df / | awk 'NR==2 {print $5}' | tr -d '%')
[ "$DISK" -gt 80 ] && curl -s "$WEBHOOK" -d "Cảnh báo: đĩa $DISK%"

docker compose ps --format json | jq -r 'select(.State != "running") | .Name' | while read -r name; do
    curl -s "$WEBHOOK" -d "Cảnh báo: container $name không chạy"
done
Không cần hệ thống giám sát phức tạp — một cảnh báo khi đĩa vượt 80% và khi container chết đã xử lý phần lớn sự cố.
Sao lưu là thứ không có lựa chọn:
# Sao lưu database hàng ngày, giữ 7 bản
0 2 * * * docker compose exec -T sqlserver /opt/mssql-tools18/bin/sqlcmd \
    -S localhost -U sa -P "$SA_PASSWORD" -C \
    -Q "BACKUP DATABASE CrmDb TO DISK='/var/opt/mssql/backup/crm.bak' WITH INIT, COMPRESSION"
Và sao lưu phải được kiểm tra khôi phục — một bản backup chưa từng khôi phục thử là một bản backup không tồn tại.
15.5.6 — Rà lại code của bạn
Danh sách rà soát VPS
- SSH tắt đăng nhập bằng mật khẩu và tắt đăng nhập root.
- Đã xác nhận đăng nhập bằng khoá trước khi đóng phiên cũ.
- Tường lửa mặc định chặn, chỉ mở 22, 80, 443.
- Không mở cổng database hay cache ra ngoài.
- fail2ban và unattended-upgrades đã bật.
- Nginx có Upgrade, Connection, X-Forwarded-* và proxy_read_timeout dài.
- client_max_body_size khớp giới hạn upload của ứng dụng.
- UseForwardedHeaders được gọi trước mọi middleware khác.
- KnownProxies giới hạn, không tin header từ mọi nguồn.
- certbot renew --dry-run đã chạy thành công.
- Script deploy chờ health check và tự rollback khi thất bại.
- Log Docker có max-size; có cron dọn image cũ.
- Có cảnh báo khi đĩa vượt ngưỡng và khi container chết.
- Có sao lưu database tự động, và đã thử khôi phục ít nhất một lần.
Bài tập áp dụng
Bài 1 — Đếm số lần dò mật khẩu SSH
Trên một VPS mới bật, chạy sudo journalctl -u ssh | grep -c "Failed password" sau 24 giờ. Tắt đăng nhập mật khẩu và so sánh sau 24 giờ nữa.
Tiêu chí hoàn thành: bạn giải thích được vì sao đổi cổng SSH không phải biện pháp bảo mật, và nêu được thứ tự ưu tiên khi làm cứng SSH.
Gợi ý và lời giải — Bài 1
Gợi ý. Bot quét internet mất bao lâu để tìm ra một cổng đang mở?
Lời giải:
sudo journalctl -u ssh --since "24 hours ago" | grep -c "Failed password"14827# Tài khoản nào bị thử nhiều nhất
sudo journalctl -u ssh --since "24 hours ago" \
| grep "Failed password" | awk '{print $(NF-5)}' | sort | uniq -c | sort -rn | head 8214 root
1203 admin
892 ubuntu
641 test
478 user
312 postgres# IP nguồn
sudo journalctl -u ssh --since "24 hours ago" \
| grep "Failed password" | grep -oE "from [0-9.]+" | sort | uniq -c | sort -rn | head -5 2841 from 45.xxx.xxx.12
1902 from 103.xxx.xxx.87
1455 from 194.xxx.xxx.203Gần 15.000 lần thử trong 24 giờ, trên một máy không ai biết địa chỉ. Đây là mức nền của internet: bot quét toàn bộ không gian IPv4 liên tục, và một máy mới thường bị dò trong vòng vài phút sau khi có IP công khai.
Tắt đăng nhập mật khẩu:
# /etc/ssh/sshd_config.d/99-lam-cung.conf
PasswordAuthentication no
PubkeyAuthentication yes
PermitRootLogin no
KbdInteractiveAuthentication no
UsePAM yes
MaxAuthTries 3
AllowUsers deploysudo sshd -t && sudo systemctl reload sshLuôn chạy sshd -t trước khi reload, và giữ phiên SSH hiện tại mở cho tới khi bạn xác minh được phiên mới — một lỗi cú pháp trong sshd_config có thể khoá bạn ra khỏi máy vĩnh viễn.
sudo journalctl -u ssh --since "24 hours ago" | grep -c "Failed password"0Bot vẫn kết nối, nhưng không còn cơ chế nào để chúng thử:
sudo journalctl -u ssh --since "24 hours ago" | grep -c "Connection closed by authenticating user"1120411.204 lần thử, 0 lần có cơ hội thành công.
Vì sao đổi cổng SSH không phải biện pháp bảo mật — đây là phần chính của bài:
Port 2222 # "không ai tìm ra đâu"nmap -p- <ip> --min-rate 5000PORT STATE SERVICE
2222/tcp open sshQuét toàn bộ 65.535 cổng của một máy mất vài giây với công cụ hiện đại. Và masscan quét cả internet cho một cổng trong vài phút. Cổng 2222 nằm trong danh sách mà mọi bot đều thử trước.
Nó là security through obscurity: nó dựa vào việc kẻ tấn công không biết, trong khi việc biết là chuyện tầm thường.
Đổi cổng:              giảm TIẾNG ỒN trong log
                       KHÔNG giảm rủi ro trước kẻ tấn công có chủ đích

Tắt mật khẩu:          loại bỏ HẲN một lớp tấn công
                       kẻ tấn công cần khoá riêng, không thể đoán ra
Đổi cổng vẫn có một lợi ích thật: log sạch hơn, nên bạn thấy được lần thử có chủ đích giữa đống nhiễu. Nhưng đó là lợi ích về khả năng quan sát, không phải về bảo mật — và nó có cái giá là mọi thành viên phải nhớ cổng, và mọi script phải cấu hình thêm.
Thứ tự ưu tiên khi làm cứng SSH:
1. Tắt đăng nhập mật khẩu           <- hiệu quả nhất, làm trước tiên
2. Tắt đăng nhập root
3. Khoá SSH có passphrase, dùng ssh-agent
4. AllowUsers hoặc AllowGroups      <- giới hạn ai được đăng nhập
5. fail2ban                         <- giảm nhiễu, chặn IP dò dai dẳng
6. Tường lửa chỉ cho IP tin cậy     <- nếu IP của bạn cố định
7. Đổi cổng                         <- CUỐI CÙNG, và chỉ để giảm nhiễu
Mục 1 và 2 cho khoảng 95% lợi ích. Các mục sau là phòng thủ nhiều lớp.
fail2ban — vẫn hữu ích sau khi đã tắt mật khẩu:
# /etc/fail2ban/jail.local
[sshd]
enabled  = true
maxretry = 3
findtime = 10m
bantime  = 1h
Nó không ngăn được gì thêm (bot đã không thể vào), nhưng nó giảm tải CPU và giữ log đọc được.
Cấu hình khuyến nghị đầy đủ:
# /etc/ssh/sshd_config.d/99-lam-cung.conf
PasswordAuthentication no
PubkeyAuthentication yes
PermitRootLogin no
PermitEmptyPasswords no
KbdInteractiveAuthentication no
MaxAuthTries 3
MaxSessions 5
LoginGraceTime 30
AllowUsers deploy
X11Forwarding no
AllowAgentForwarding no
ClientAliveInterval 300
ClientAliveCountMax 2

# Chỉ thuật toán hiện đại
KexAlgorithms curve25519-sha256,[email protected]
Ciphers [email protected],[email protected]
MACs [email protected],[email protected]
Sinh khoá đúng cách:
ssh-keygen -t ed25519 -C "deploy@crm" -f ~/.ssh/crm_deployed25519 thay vì RSA: khoá ngắn hơn, nhanh hơn, và không có tham số kích thước để chọn sai. Nếu buộc phải dùng RSA (hệ thống cũ), tối thiểu 4096 bit.
Kiểm chứng sau khi cấu hình:
# Phải THẤT BẠI
ssh -o PreferredAuthentications=password -o PubkeyAuthentication=no deploy@serverPermission denied (publickey).# Xem cấu hình thật mà sshd đang dùng
sudo sshd -T | grep -E "^(passwordauthentication|permitrootlogin|pubkeyauthentication)"passwordauthentication no
permitrootlogin no
pubkeyauthentication yessshd -T in ra cấu hình đã được giải quyết, kể cả những giá trị đến từ file include hay từ mặc định — nên nó là nguồn đáng tin duy nhất. Đọc sshd_config bằng mắt có thể bỏ sót một dòng ghi đè trong sshd_config.d/.
Và một điều dễ bị bỏ qua: cũng làm cứng những thứ khác đang mở.
sudo ss -tlnp | grep -v "127.0.0.1\|::1"SSH được làm cứng kỹ lưỡng không giúp được gì nếu cổng 1433 của SQL Server đang mở ra internet với mật khẩu sa mặc định — đúng vấn đề ở bài 15.3.
Bài 2 — Quên UseForwardedHeaders
Bỏ UseForwardedHeaders nhưng bật UseHttpsRedirection, và quan sát vòng lặp chuyển hướng. Log RemoteIpAddress để xác nhận nó là IP của Nginx.
Tiêu chí hoàn thành: bạn giải thích được vòng lặp hình thành thế nào, và nêu được ba thứ khác bị hỏng khi thiếu forwarded headers.
Gợi ý và lời giải — Bài 2
Gợi ý. Nginx nhận HTTPS và chuyển tiếp bằng HTTP. Kestrel thấy giao thức gì?
Lời giải — cấu hình gây lỗi:
server {
    listen 443 ssl;
    server_name crm.example.com;

    location / {
        proxy_pass http://127.0.0.1:8080;     # HTTP tới Kestrel
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}var app = builder.Build();
app.UseHttpsRedirection(); // KHÔNG có UseForwardedHeaders trước đócurl -IL https://crm.example.com/healthHTTP/1.1 307 Temporary Redirect
Location: https://crm.example.com/health
HTTP/1.1 307 Temporary Redirect
Location: https://crm.example.com/health
...
curl: (47) Maximum (50) redirects followedTrình duyệt báo ERR_TOO_MANY_REDIRECTS.
Vòng lặp hình thành thế nào:
1. Trình duyệt -> https://crm.example.com/health
2. Nginx nhận HTTPS, giải mã TLS
3. Nginx -> http://127.0.0.1:8080/health          <- HTTP, không mã hoá
4. Kestrel thấy Request.Scheme == "http"
5. UseHttpsRedirection: "chưa HTTPS!" -> 307 tới https://crm.example.com/health
6. Nginx trả 307 về trình duyệt
7. Trình duyệt đi tới https://crm.example.com/health
8. Quay lại bước 2 — vòng lặp vô hạn
Mắt xích sai là bước 4. Nginx đã gửi X-Forwarded-Proto: https, nhưng ASP.NET Core không tự đọc header đó — vì tin một header tuỳ ý từ client là một lỗ hổng bảo mật.
Nếu ASP.NET Core tự tin X-Forwarded-Proto:
    kẻ tấn công gửi "X-Forwarded-Proto: https" tới một endpoint HTTP
    -> ứng dụng tưởng kết nối đã mã hoá
    -> gửi cookie có cờ Secure qua kết nối KHÔNG mã hoá
Nên bạn phải bật tường minh, và khai báo proxy nào đáng tin:
builder.Services.Configure<ForwardedHeadersOptions>(o =>
{
    o.ForwardedHeaders = ForwardedHeaders.XForwardedFor | ForwardedHeaders.XForwardedProto;

    // Nginx chạy trên cùng máy — chỉ tin nó
    o.KnownProxies.Clear();
    o.KnownNetworks.Clear();
    o.KnownProxies.Add(IPAddress.Parse("127.0.0.1"));
    o.KnownProxies.Add(IPAddress.IPv6Loopback);
});var app = builder.Build();
app.UseForwardedHeaders(); // PHẢI đứng đầu, trước mọi middleware khác
app.UseHttpsRedirection();
app.UseAuthentication();
app.UseAuthorization();Thứ tự là quyết định: UseForwardedHeaders sửa Request.Scheme và Connection.RemoteIpAddress, nên mọi middleware đọc hai giá trị đó phải chạy sau nó.
curl -IL https://crm.example.com/healthHTTP/1.1 200 OKBa thứ khác bị hỏng khi thiếu forwarded headers:
1. RemoteIpAddress là IP của Nginx, không phải của người dùng.
_logger.LogInformation("Request từ {Ip}", context.Connection.RemoteIpAddress);Thiếu: Request từ 127.0.0.1 <- mọi request đều giống nhau
Có: Request từ 203.0.113.42Hậu quả dây chuyền:
Rate limiting theo IP    -> MỌI người dùng chung một "IP" -> giới hạn toàn cục
                            một người dùng nặng chặn tất cả những người khác
Chặn IP độc hại          -> chặn 127.0.0.1 = chặn toàn bộ traffic
Audit log                -> không truy được ai làm gì
Geo-location             -> mọi người dùng đều ở vị trí của máy chủ
Phát hiện bất thường     -> không phân biệt được 1 người gọi 10.000 lần
                            với 10.000 người mỗi người gọi 1 lần
Dòng đầu là nguy hiểm nhất, vì nó biến rate limiting từ một biện pháp bảo vệ thành một lỗ hổng từ chối dịch vụ.
2. URL sinh ra dùng sai scheme.
var url = Url.Action("XacNhan", "Email", new { token }, Request.Scheme);
await _emailSender.GuiAsync(email, "Xác nhận", $"Bấm vào đây: {url}");Thiếu: http://crm.example.com/email/xac-nhan?token=abc <- HTTP!
Có: https://crm.example.com/email/xac-nhan?token=abcToken xác nhận đi qua kết nối không mã hoá. Và trình duyệt hiện đại chặn nội dung hỗn hợp, nên link trong email có thể không hoạt động.
Điều tương tự xảy ra với OAuth redirect URI — và ở đó, scheme sai khiến nhà cung cấp từ chối hẳn:
The redirect_uri 'http://crm.example.com/signin-oidc' does not match
the registered redirect URI 'https://crm.example.com/signin-oidc'.
3. Cookie có cờ Secure không được gửi.
options.Cookie.SecurePolicy = CookieSecurePolicy.SameAsRequest;Với Request.Scheme == "http", cookie được đặt không có cờ Secure — nên nó có thể bị gửi qua kết nối không mã hoá. Đây là một lỗ hổng thật, không chỉ là bất tiện.
Sửa bằng cách đặt tường minh, đừng dựa vào scheme:
options.Cookie.SecurePolicy = CookieSecurePolicy.Always;
options.Cookie.HttpOnly = true;
options.Cookie.SameSite = SameSiteMode.Lax;
Cấu hình cho các tầng proxy khác nhau:
// Một Nginx trên cùng máy
o.KnownProxies.Add(IPAddress.Loopback);

// Nginx ở máy khác trong mạng nội bộ
o.KnownNetworks.Add(new IPNetwork(IPAddress.Parse("10.0.0.0"), 8));

// Sau Cloudflare rồi tới Nginx — HAI tầng
o.ForwardLimit = 2;
o.KnownNetworks.Add(new IPNetwork(IPAddress.Parse("173.245.48.0"), 20));   // dải Cloudflare
ForwardLimit mặc định là 1. Với hai tầng proxy mà không tăng nó, bạn lấy được IP của Nginx thay vì của người dùng cuối.
Và một cảnh báo về cấu hình lỏng:
// NGUY HIỂM — tin MỌI proxy
o.KnownProxies.Clear();
o.KnownNetworks.Clear();
o.ForwardLimit = null;
Cấu hình này hay xuất hiện trong các bài hướng dẫn vì nó "làm cho nó chạy". Nhưng nếu ứng dụng có thể tiếp cận trực tiếp — không qua proxy — thì bất kỳ ai cũng giả mạo được IP của mình:
curl -H "X-Forwarded-For: 1.2.3.4" https://crm.example.com/api/...Và rate limiting, audit log, chặn IP đều bị vô hiệu.
Nếu bạn thật sự không biết trước IP của proxy (ví dụ trong Kubernetes với IP pod động), hãy dùng cấu hình lỏng kèm bảo đảm rằng ứng dụng không thể tiếp cận trực tiếp — chỉ nghe trên mạng nội bộ, và NetworkPolicy chỉ cho ingress controller gọi vào.
Kiểm chứng:
app.Use(async (ctx, next) =>
{
    _logger.LogInformation("Scheme={Scheme} IP={Ip} XFF={Xff} XFP={Xfp}",
        ctx.Request.Scheme,
        ctx.Connection.RemoteIpAddress,
        ctx.Request.Headers["X-Forwarded-For"].ToString(),
        ctx.Request.Headers["X-Forwarded-Proto"].ToString());
    await next();
});Scheme=https IP=203.0.113.42 XFF=203.0.113.42 XFP=https <- đúng
Scheme=http IP=127.0.0.1 XFF=203.0.113.42 XFP=https <- header CÓ nhưng chưa được ápDòng thứ hai là triệu chứng đặc trưng: header có mặt, nhưng UseForwardedHeaders chưa chạy hoặc proxy chưa được tin.
Bài 3 — Deploy có rollback tự động
Deploy một image cố tình fail health check và xác nhận script tự quay về phiên bản cũ, dịch vụ không gián đoạn.
Tiêu chí hoàn thành: script của bạn xử lý đúng ba tình huống mà bản viết vội thường bỏ sót.
Gợi ý và lời giải — Bài 3
Gợi ý. Nếu health check chưa từng pass, "phiên bản cũ" là gì? Và nếu chính script chết giữa chừng?
Lời giải — script đầy đủ:
#!/usr/bin/env bash
set -euo pipefail

IMAGE_MOI="$1"
TEN="crm-api"
TEN_CU="${TEN}-cu"
CONG_MOI=8081
CONG_CU=8080
HEALTH_TIMEOUT=60

log() { echo "[$(date +%H:%M:%S)] $*"; }

# 1. Ghi lại image hiện tại ĐỂ QUAY VỀ
IMAGE_CU=$(docker inspect "$TEN" --format '{{.Config.Image}}' 2>/dev/null || echo "")
log "Phiên bản hiện tại: ${IMAGE_CU:-(chưa có)}"

# 2. Dọn container tạm còn sót từ lần deploy hỏng trước
docker rm -f "$TEN_CU" 2>/dev/null || true

# 3. Khởi động phiên bản MỚI ở cổng khác — CHƯA nhận traffic
log "Khởi động $IMAGE_MOI ở cổng $CONG_MOI"
docker run -d --name "$TEN_CU" \
    --restart unless-stopped \
    --env-file /etc/crm/.env \
    -p "127.0.0.1:${CONG_MOI}:8080" \
    "$IMAGE_MOI"

# 4. Chờ health check, có timeout
log "Chờ health check (tối đa ${HEALTH_TIMEOUT}s)"
KHOE=false
for i in $(seq 1 "$HEALTH_TIMEOUT"); do
    if curl -fsS --max-time 2 "http://127.0.0.1:${CONG_MOI}/health/ready" > /dev/null 2>&1; then
        KHOE=true
        log "Health check PASS sau ${i}s"
        break
    fi
    # Container chết hẳn thì không cần chờ hết timeout
    if ! docker ps -q -f name="$TEN_CU" | grep -q .; then
        log "Container đã thoát — dừng chờ"
        break
    fi
    sleep 1
done

# 5. Thất bại -> dọn dẹp và giữ nguyên phiên bản cũ
if [ "$KHOE" = false ]; then
    log "HEALTH CHECK THẤT BẠI. Log của phiên bản mới:"
    docker logs --tail 50 "$TEN_CU" 2>&1 | sed 's/^/    /'
    docker rm -f "$TEN_CU" 2>/dev/null || true
    log "Đã huỷ triển khai. Phiên bản cũ ${IMAGE_CU} vẫn đang chạy."
    exit 1
fi

# 6. Chuyển đổi — đổi tên và cổng
log "Chuyển traffic sang phiên bản mới"
docker rm -f "$TEN" 2>/dev/null || true
docker rename "$TEN_CU" "$TEN"

# Container không đổi cổng được lúc chạy -> tạo lại ở cổng đúng
docker stop "$TEN" && docker rm "$TEN"
docker run -d --name "$TEN" \
    --restart unless-stopped \
    --env-file /etc/crm/.env \
    -p "127.0.0.1:${CONG_CU}:8080" \
    "$IMAGE_MOI"

# 7. Xác minh LẦN NỮA sau khi chuyển
for i in $(seq 1 30); do
    if curl -fsS --max-time 2 "http://127.0.0.1:${CONG_CU}/health/ready" > /dev/null 2>&1; then
        log "Triển khai thành công: $IMAGE_MOI"
        docker image prune -af --filter "until=168h" > /dev/null 2>&1 || true
        exit 0
    fi
    sleep 1
done

# 8. Chuyển xong nhưng vẫn hỏng -> quay về image cũ
log "Phiên bản mới hỏng sau khi chuyển. Quay về ${IMAGE_CU}"
docker rm -f "$TEN" 2>/dev/null || true
if [ -n "$IMAGE_CU" ]; then
    docker run -d --name "$TEN" \
        --restart unless-stopped \
        --env-file /etc/crm/.env \
        -p "127.0.0.1:${CONG_CU}:8080" \
        "$IMAGE_CU"
fi
exit 1
Ba tình huống mà bản viết vội thường bỏ sót:
Tình huống 1 — deploy đầu tiên, chưa có phiên bản cũ.
IMAGE_CU=$(docker inspect "$TEN" --format '{{.Config.Image}}') # THẤT BẠI, script dừngVới set -e, script chết ngay ở dòng này trong lần deploy đầu tiên. Bản đầy đủ xử lý bằng 2>/dev/null || echo "" và kiểm tra [ -n "$IMAGE_CU" ] trước khi rollback.
Tình huống 2 — container mới chết ngay, nhưng script vẫn chờ hết 60 giây.
Vòng lặp chỉ kiểm tra HTTP. Nếu container thoát sau 2 giây vì thiếu cấu hình, script chờ thêm 58 giây vô ích — và trên một pipeline có nhiều môi trường, thời gian đó cộng dồn.
if ! docker ps -q -f name="$TEN_CU" | grep -q .; then break; fiTình huống 3 — chuyển đổi xong rồi mới hỏng.
Đây là tình huống nguy hiểm nhất và hay bị bỏ sót nhất. Health check pass ở cổng 8081, nhưng sau khi tạo lại container ở cổng 8080, nó hỏng — có thể vì cấu hình khác, vì cổng đã bị chiếm, hoặc vì một điều kiện chỉ xuất hiện khi có traffic thật.
Bản viết vội kết thúc ở bước 6 và báo "thành công", trong khi dịch vụ đang chết. Bước 7 và 8 là thứ biến script này từ "tự động hoá việc deploy" thành "tự động hoá việc deploy an toàn".
Ba thứ khác nên có:
1. Khoá để không có hai lần deploy chồng nhau:
exec 200>/var/lock/crm-deploy.lock
flock -n 200 || { echo "Một lần deploy khác đang chạy"; exit 1; }
2. Thông báo kết quả — deploy im lặng là deploy không ai biết đã hỏng:
thong_bao() {
    curl -sf -X POST "$SLACK_WEBHOOK" \
        -H 'Content-Type: application/json' \
        -d "{\"text\":\"$1\"}" > /dev/null || true
}
trap 'thong_bao ":x: Deploy $IMAGE_MOI THẤT BẠI trên $(hostname)"' ERR
3. Dùng Nginx để chuyển traffic thay vì tạo lại container — cách sạch hơn nhiều:
upstream crm_backend {
    server 127.0.0.1:8080;      # xanh
    # server 127.0.0.1:8081;    # lam
}# Chuyển bằng cách đổi file upstream rồi reload — KHÔNG gián đoạn
sed -i 's/8080/8081/' /etc/nginx/conf.d/crm-upstream.conf
nginx -t && systemctl reload nginxnginx -t trước reload là bắt buộc, và reload (khác restart) hoàn tất các kết nối đang mở trước khi chuyển — nên thật sự không có request nào bị mất.
Và câu hỏi đáng hỏi cuối cùng: có nên tự viết script này không?
1 máy chủ, deploy vài lần một tuần       -> script như trên là hợp lý
Nhiều máy chủ, deploy nhiều lần một ngày -> dùng công cụ có sẵn
Vì script tự viết sẽ dần cần: nhiều máy chủ, rolling update, canary, quan sát được, khôi phục sau khi chính script chết giữa chừng. Đó là những thứ Kubernetes, Nomad, hay một PaaS đã giải quyết — và giải quyết tốt hơn.
Nhưng viết script này một lần vẫn đáng, vì nó cho bạn hiểu chính xác những gì một hệ thống triển khai phải xử lý — và ba tình huống ở trên chính là ba thứ mà một công cụ tốt làm đúng còn một công cụ tồi thì không.
Tự kiểm tra
Vì sao phải tắt đăng nhập SSH bằng mật khẩu?
Một server có IP công khai bắt đầu nhận hàng nghìn lượt dò mật khẩu mỗi ngày trong vòng vài phút sau khi bật. Khoá SSH loại bỏ hoàn toàn nhóm tấn công đó. Nhưng phải xác nhận đăng nhập bằng khoá được trước khi đóng phiên hiện tại.
Những header nào Nginx bắt buộc phải chuyển tiếp?
Upgrade và Connection cho WebSocket, nếu thiếu thì SignalR luôn rơi về long polling mà không có lỗi nào. Host, X-Real-IP, X-Forwarded-For và X-Forwarded-Proto cho UseForwardedHeaders. Và proxy_read_timeout phải đủ dài, mặc định 60 giây sẽ cắt kết nối SignalR mỗi phút.
Quên UseForwardedHeaders gây ra gì?
ASP.NET Core thấy mọi request là HTTP đến từ IP của Nginx. UseHttpsRedirection sẽ chuyển hướng vô tận vì nó luôn thấy HTTP, và rate limit theo IP chặn nhầm mọi người dùng như một vì tất cả có cùng IP.
Vì sao KnownProxies quan trọng?
Không giới hạn, bất kỳ ai cũng gửi header X-Forwarded-For giả để vượt rate limit theo IP hoặc giả mạo địa chỉ trong log. Phải xoá danh sách mặc định và chỉ thêm IP của proxy thật.
client_max_body_size mặc định là bao nhiêu?
1 MB. Ứng dụng cấu hình 20 MB nhưng Nginx chặn ở 1 MB, và client nhận lỗi 413 từ Nginx mà không có gì trong log ứng dụng. Hai giới hạn phải khớp nhau.
Ba thứ phổ biến nhất làm chết một VPS là gì?
Đầy đĩa do log Docker không giới hạn và image cũ tích tụ, hết bộ nhớ khiến container bị OOM kill, và chứng chỉ TLS hết hạn vì gia hạn thất bại im lặng. Một cảnh báo khi đĩa vượt 80 phần trăm và khi container chết đã xử lý phần lớn.
Kết luận
Ba điều đáng nhớ nhất:
- Tắt SSH bằng mật khẩu trước khi làm bất cứ gì khác.
UseForwardedHeadersvớiKnownProxiesgiới hạn — thiếu nó là vòng lặp chuyển hướng và rate limit sai.- Đầy đĩa vì log Docker là nguyên nhân số một làm chết VPS. Đặt
max-size.
Tham khảo
- Host ASP.NET Core on Linux with Nginx
- Configure ASP.NET Core to work with proxy servers
- Certbot documentation
- Docker logging drivers
Điều hướng
- Bài trước: 15.4 — Environment và Secrets
- Bài tiếp theo: 15.6 — GitHub Actions CI/CD
- Về module: Trang mục lục
Bài liên quan
- Forward header trong ASP.NET Core: vì sao 'forward hết' là một lỗi kiến trúc — Vòng lặp copy mọi header từ request đi vào sang lời gọi HttpClient đi ra là đoạn code trông vô hại nhất mà tôi từng thấy gây sự cố production.